Khoảng trống sau lời hứa năng suất
AI agent đang được giới thiệu như những “nhân sự số” có thể nhận trọn một nhiệm vụ. Nhưng trong xu hướng agent-first, năng suất thật chỉ được tính khi kết quả đã được kiểm tra, sửa và chấp nhận.
Đầu năm 2025, trong một thử nghiệm có đối chứng, các lập trình viên giàu kinh nghiệm tin rằng AI giúp họ nhanh hơn 20%, trong khi số đo cho thấy họ chậm hơn 19% [3]. Một năm sau, chính nhóm nghiên cứu cho rằng AI nhiều khả năng đã giúp lập trình viên làm nhanh hơn, nhưng thừa nhận chưa đo được chính xác là bao nhiêu [4]. Công cụ thay đổi nhanh hơn khả năng đo lường. Đó là điểm khởi đầu để nhìn lại lời hứa của nhân sự số.
Nhân sự số đặt ra một lời hứa hấp dẫn: nhiều công việc hơn được hoàn thành trong thời gian ngắn hơn. Nhưng giữa một kết quả được tạo ra và một kết quả đủ tốt để sử dụng vẫn còn phần việc của người kiểm tra, sửa chữa và chịu trách nhiệm. Phần việc ấy cần được tính đủ khi doanh nghiệp đánh giá hiệu quả của AI.
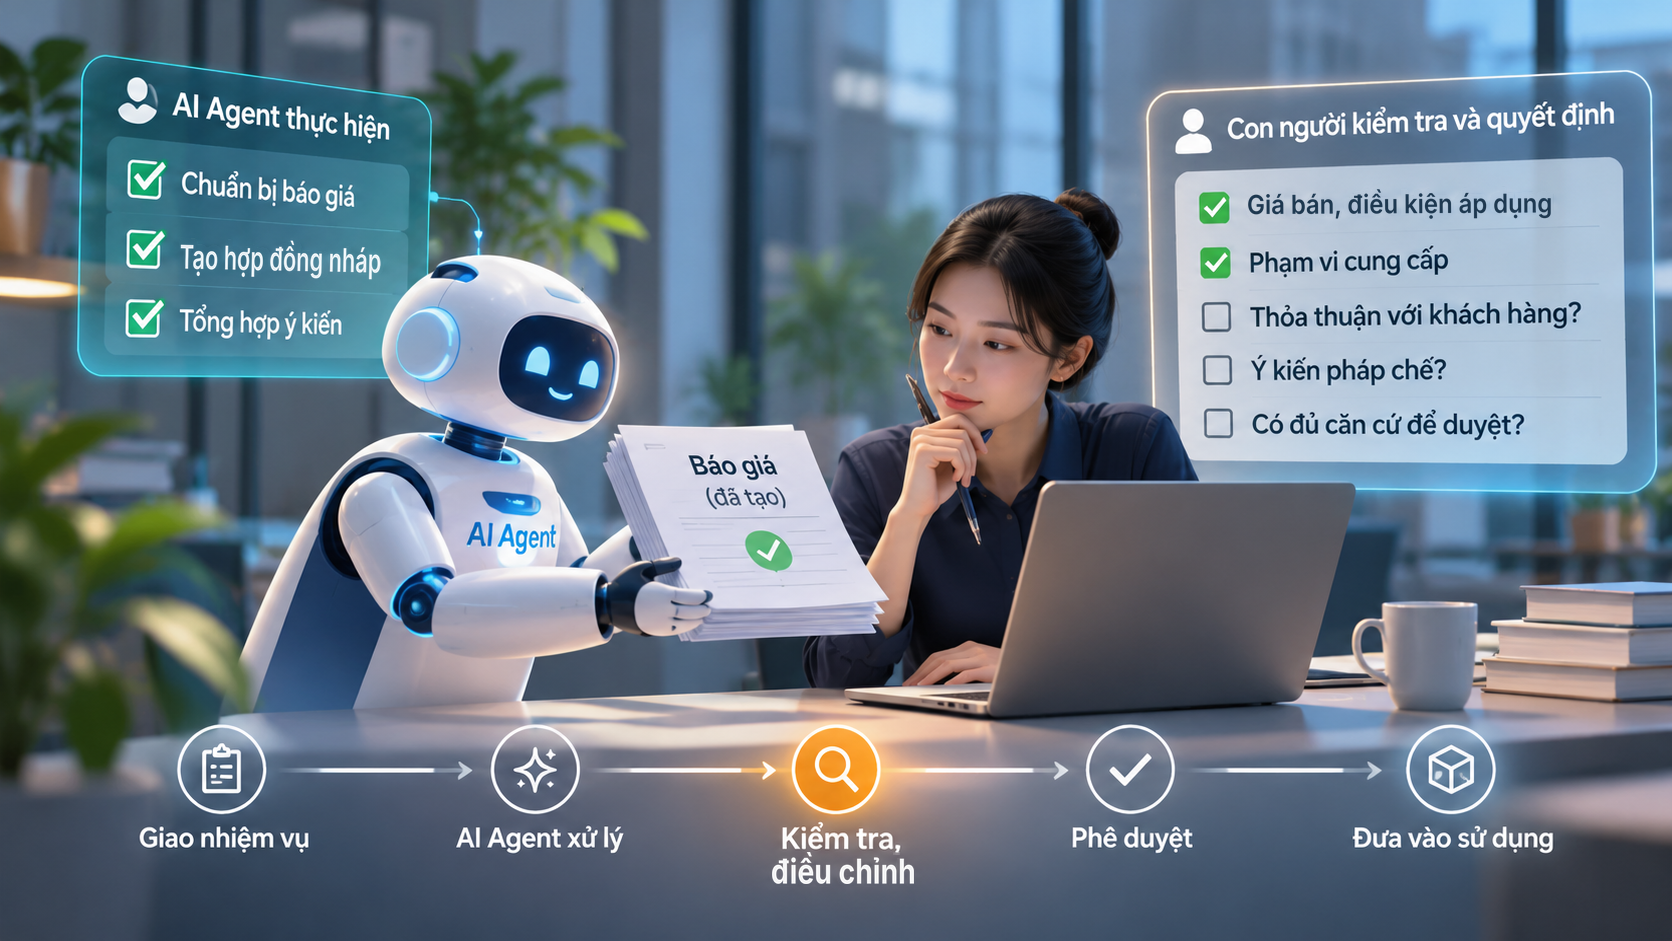
Có thể hình dung qua một báo giá. Agent chuẩn bị bản nháp, điền danh mục sản phẩm và tổng hợp điều kiện thương mại. Người phụ trách vẫn phải đối chiếu giá bán, phạm vi cung cấp, lịch thanh toán và những cam kết với khách hàng. Một điều khoản sai có thể khiến toàn bộ phần thời gian tiết kiệm được trở nên ít ý nghĩa.
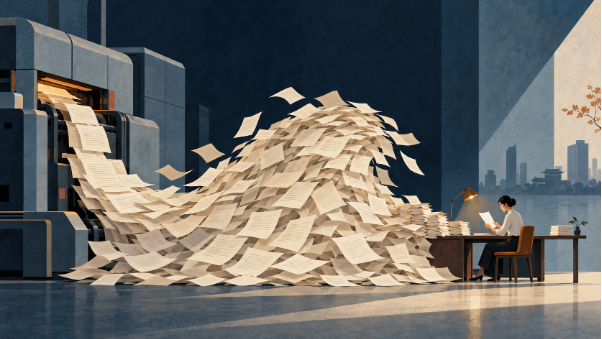
Nếu số báo giá được tạo ra tăng lên nhưng khả năng kiểm tra không thay đổi, công việc sẽ dồn trước bàn người duyệt. Doanh nghiệp có thêm đầu ra, còn khách hàng chưa chắc nhận được kết quả sớm hơn.
Đó là khả năng cần được tính đến khi chuyển sang agent-first: cách tổ chức công việc trong đó AI agent nhận trọn nhiệm vụ, thay vì chỉ gợi ý từng bước như một trợ lý (copilot). Đi kèm với đó, con người phải tổ chức lại cách giám sát và đánh giá. Năng lực nghiệm thu có thể trở thành giới hạn của việc mở rộng nhân sự số.
Phần việc nằm ngoài bản trình diễn
Theo case study do Anthropic công bố về Doctolib [1], doanh nghiệp này thí điểm Claude Code với 30 kỹ sư trước khi mở rộng cho toàn đội. Công cụ được tích hợp vào quy trình bảo trì phần mềm và cập nhật tài liệu kỹ thuật. Đội nền tảng cũng xây dựng kho prompt, lệnh tùy chỉnh và subagent dùng chung.
Chi tiết đáng chú ý là cách sử dụng công cụ được chuẩn hóa cùng với việc triển khai. Các kỹ sư có những hướng dẫn chung để giao nhiệm vụ và đưa kết quả vào quy trình làm việc.
Tại Việt Nam, nhân sự số cũng đang đến gần hơn với công việc hằng ngày của doanh nghiệp. Đã có giải pháp trong nước hướng tới các nghiệp vụ như chuẩn bị báo giá, hỗ trợ soạn hợp đồng và tổng hợp ý kiến từ nhiều bộ phận.
Một quy trình thực tế luôn có nhiều điều kiện mà bản trình diễn khó thể hiện hết. Giá nào đang có hiệu lực? Thỏa thuận nào đã được khách hàng xác nhận? Ý kiến nào của bộ phận pháp chế chưa được giải quyết? Ai có quyền chấp nhận ngoại lệ?
Một kết quả có thể đầy đủ về hình thức nhưng chưa đủ căn cứ để sử dụng. Vẫn phải có người hoặc cơ chế kiểm tra phù hợp để phát hiện khoảng thiếu đó.
Vì vậy, hiệu quả phải được đánh giá đến lúc công việc được chấp nhận. Dừng phép đo ở thời điểm agent trả lời sẽ bỏ sót phần công sức phía sau.
Tiêu chí “đạt” đang nằm trong đầu ai?
Giả sử một doanh nghiệp đã lưu đầy đủ hồ sơ của các dự án trước. Khi gặp dự án tương tự, đội ngũ vẫn phải tìm người từng phụ trách để hỏi vì sao đã chọn phương án ấy, vì sao một hạng mục vượt dự toán, hay vì sao một yêu cầu tưởng đơn giản lại cần nhiều lần trao đổi.
Hồ sơ có thể ghi lại quyết định mà thiếu căn cứ dẫn đến quyết định. Người có kinh nghiệm còn nhớ những ràng buộc, dấu hiệu cảnh báo và lựa chọn đã bị loại bỏ.
Phần hiểu biết ấy ảnh hưởng trực tiếp đến việc nghiệm thu. Hai bản đề xuất cùng đáp ứng một danh sách yêu cầu vẫn có thể khác nhau đáng kể về tính khả thi. Người duyệt phải hiểu hoàn cảnh áp dụng mới đánh giá được.
Khi giao việc cho agent, những điều trước đây vẫn dựa vào kinh nghiệm và sự hiểu ý cần được viết ra càng nhiều càng tốt. Nếu yêu cầu chỉ là “làm như các dự án trước”, người duyệt sẽ phải tự bổ sung bối cảnh cho từng kết quả.
Việc mở rộng khi đó tiếp tục phụ thuộc vào một số ít chuyên gia. Công cụ có thể được cấp thêm, nhưng thời gian của những người này thì có hạn.
Một cách chuẩn bị thiết thực là ghi lại lý do sửa, điều kiện chấp nhận ngoại lệ và những sai sót thường gặp. Các nội dung ấy cần được rà soát để trở thành hướng dẫn và tình huống kiểm tra dùng chung.
Không phải mọi phán đoán đều có thể viết thành quy tắc. Chính vì vậy, doanh nghiệp phải xác định phần nào kiểm tra được theo tiêu chí rõ ràng, phần nào vẫn cần chuyên gia quyết định.
Phần đã thành tiêu chí rõ ràng có thể giao cho lớp kiểm tra tự động: đối chiếu giá với bảng giá đang có hiệu lực, rà các điều khoản bắt buộc trong hợp đồng, chạy kiểm thử với mã nguồn, hoặc dùng một agent khác kiểm tra chéo. Khi máy lọc trước những lỗi đo được, thời gian của chuyên gia được dành cho phần thực sự cần phán đoán.
Một chữ “duyệt” cần bao nhiêu hiểu biết?
Đưa con người vào bước phê duyệt chưa đủ để kết luận rằng kết quả đã được kiểm soát. Người duyệt cần có chuyên môn, thông tin và thời gian. Họ cũng phải được quyền yêu cầu làm lại hoặc dừng công việc khi chưa đủ căn cứ.
Nghiên cứu của Anthropic về Claude Code công bố tháng 6/2026 [2], dựa trên khoảng 400.000 phiên làm việc từ tháng 10/2025 đến tháng 4/2026, ghi nhận mối liên hệ giữa chuyên môn người dùng và kết quả phiên. Theo tiêu chí thành công chặt nhất của nghiên cứu, nhóm mới bắt đầu đạt khoảng 15%, còn nhóm có chuyên môn từ trung bình trở lên đạt 28–33%.
Những con số này cần được đọc trong giới hạn phương pháp. Mức chuyên môn và kết quả được đánh giá từ nội dung phiên làm việc, có sử dụng mô hình phân loại. Nghiên cứu chỉ ước tính giá trị tương đối của nhiệm vụ, chưa đo được việc sản phẩm cuối cùng có thực sự được sử dụng hay không.
Dù vậy, kết quả là một căn cứ để cân nhắc vai trò của chuyên gia trong triển khai agent. Họ cần tham gia từ lúc xác định nhiệm vụ và tiêu chí đánh giá. Nếu chỉ xuất hiện ở bước cuối, chuyên gia có thể phải sửa cả cách giao việc lẫn sản phẩm đã tạo ra.
Một bước phê duyệt chỉ có ý nghĩa khi người duyệt thực sự có khả năng phản biện. Nếu quá nhiều kết quả được chuyển đến cùng lúc, thời gian kiểm tra bị rút ngắn, còn tiến độ gây sức ép phải thông qua, cơ chế ấy có nguy cơ trở thành thủ tục.
Ai sẽ học để trở thành chuyên gia?
Ở đây xuất hiện một giả thuyết đáng quan tâm: việc giao phần lớn công việc thực thi cho agent có thể làm giảm cơ hội học nghề của nhân viên mới.
Một người học cách lập dự toán qua những lần tự tính, bỏ sót rồi được sửa. Người học lập trình tích lũy hiểu biết khi phải tìm nguyên nhân khiến mã không chạy. Nếu bắt đầu bằng việc duyệt sản phẩm của agent, họ có thể phải đánh giá những công việc mình chưa từng thực hiện.
Giả thuyết này chưa được nghiên cứu dài hạn xác nhận. Tuy nhiên, nó đặt ra một câu hỏi về phát triển đội ngũ: những người sẽ thay thế chuyên gia hiện tại cần tích lũy kinh nghiệm bằng cách nào?
Trưởng nhóm có thể giữ lại một số nhiệm vụ để nhân viên mới tự thực hiện trước khi dùng agent. Với công việc khó, người mới nên cùng chuyên gia đánh giá kết quả và giải thích căn cứ chấp nhận hoặc từ chối.
Cách làm đó có thể tốn thêm thời gian trước mắt. Đổi lại, doanh nghiệp duy trì cơ hội thực hành và truyền lại phương pháp đánh giá. Chi phí đào tạo này cần được cân nhắc khi quyết định phần việc nào nên giao cho nhân sự số.
Nếu chỉ tính thời gian hoàn thành nhiệm vụ hôm nay, doanh nghiệp có thể bỏ qua thời gian cần thiết để đào tạo người đủ khả năng chịu trách nhiệm ngày mai.
Đo cả thời gian sửa lại
Cảm giác làm nhanh hơn cần được đối chiếu với số đo.
Trong thử nghiệm của METR công bố tháng 7/2025 [3] với 16 lập trình viên nguồn mở giàu kinh nghiệm, người tham gia dự đoán AI giúp họ nhanh hơn 24%. Sau thử nghiệm, họ vẫn ước tính mình nhanh hơn 20%, trong khi thời gian thực hiện đo được tăng 19%.
Kết quả này phản ánh công cụ đầu năm 2025. Tháng 2/2026, METR công bố cập nhật [4]. Số liệu thô từ thử nghiệm mới nghiêng về hướng AI giúp làm nhanh hơn, nhưng nhóm nghiên cứu đánh giá dữ liệu chưa đáng tin cậy. Nhiều lập trình viên từ chối tham gia hoặc không đưa vào thử nghiệm những việc họ không muốn làm khi thiếu AI. Người dùng agent thường làm việc khác trong lúc chờ, nên thời gian thực hiện khó đo. Chất lượng đầu ra, như mức độ kiểm thử và tài liệu, cũng khác nhau giữa hai cách làm.
Những khó khăn ấy cho thấy năng suất của AI không thể đánh giá bằng cảm nhận hay một con số chung. Mỗi doanh nghiệp phải tự đo trong chính công việc của mình, và đo đến lúc kết quả được chấp nhận.
Thời gian nên được tính từ lúc nhận nhiệm vụ đến khi kết quả được chấp nhận. Chi phí cần gồm công cụ, người kiểm tra, công sức sửa lại và xử lý sai sót. Các số đo phải được so sánh với cách làm trước khi triển khai.
Một bộ chỉ số tối thiểu có thể gồm:
| Chỉ số | Ý nghĩa |
| Thời gian đến khi được chấp nhận | Từ lúc giao việc đến lúc kết quả được duyệt |
| Tỷ lệ đạt ngay lần đầu | Tỷ lệ kết quả được chấp nhận mà không cần sửa |
| Số vòng sửa trung bình | Chi phí ẩn của khâu nghiệm thu |
| Thời gian chờ duyệt | Mức ùn tắc trước bàn người duyệt |
| Lỗi lọt qua khâu duyệt | Bước duyệt có thực chất hay chỉ là thủ tục |
Quyền hành động cũng cần được xác định cụ thể. Chuẩn bị báo giá khác với gửi báo giá cho khách hàng. Đề xuất sửa dữ liệu khác với trực tiếp cập nhật hệ thống. Mức tự chủ nên phụ thuộc vào hậu quả nếu sai và khả năng phát hiện sai trước khi gây ảnh hưởng.
Có thể hình dung mức tự chủ theo hai trục này:
| Dễ phát hiện sai | Khó phát hiện sai | |
| Hậu quả thấp | Agent tự thực hiện | Agent thực hiện, kiểm tra theo mẫu ngẫu nhiên |
| Hậu quả cao | Agent đề xuất, con người duyệt | Con người thực hiện, agent hỗ trợ |
Khi có những căn cứ này, ban lãnh đạo mới có thể quyết định nhiệm vụ nào nên mở rộng, nhiệm vụ nào cần điều chỉnh và nhiệm vụ nào vẫn phải do con người trực tiếp thực hiện.
Lời hứa năng suất của nhân sự số vì thế cần được kiểm chứng ở nơi công việc kết thúc: kết quả đã được chấp nhận và có thể đưa vào sử dụng.
Trước khi giao thêm việc cho agent, doanh nghiệp phải trả lời được ba câu hỏi: ai sẽ duyệt, dựa trên tiêu chí nào và mất bao lâu. Khoảng thời gian sau khi agent báo “đã xong” chính là phần phải tính đủ để biết công nghệ đã giúp được bao nhiêu.
Tài liệu tham khảo
[1] Anthropic. Doctolib accelerates developer productivity with Claude Code (Customer case study). https://claude.com/customers/doctolib
[2] Hitzig, Z., Massenkoff, M., Lyubich, E., Zhang, S., Heller, R., & McCrory, P. (16/6/2026). Agentic coding and persistent returns to expertise. Anthropic Research. https://www.anthropic.com/research/claude-code-expertise
[3] Becker, J., Rush, N., Barnes, B., & Rein, D. (10/7/2025). Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity. METR. https://metr.org/blog/2025-07-10-early-2025-ai-experienced-os-dev-study/
[4] Becker, J., Rush, N., Cunningham, T., Rein, D., & Mahamud, K. (24/2/2026). We are Changing our Developer Productivity Experiment Design. METR. https://metr.org/blog/2026-02-24-uplift-update/
| Bài viết độc quyền của chuyên gia FPT IS, Tập đoàn FPT
Võ Tá Nhật Anh Kiến trúc sư giải pháp – Quản lý chương trình chuyển đổi AI, FPT IS Chuyên môn: thiết kế hệ thống, tư vấn chiến lược và giải pháp chuyển đổi số dựa trên AI và Agentic Infrastructure. |