Jev là gì? Vì sao mô hình Jev được ví như “Khoảnh khắc ChatGPT” của mô hình phân loại?
Tóm tắt nội dung
Giữa tháng 9/2026, công ty khởi nghiệp TypeSafe AI công bố mô hình AI có tên là Jev – mô hình phân loại, ra quyết định nhanh, chi phí rẻ. Ngay lập tức mô hình này trở nên “viral”, nhận được sự chú ý lớn của cộng đồng nghiên cứu và phát triển AI. Rất nhiều nhà phát triển đã dùng thử, xây dựng và chia sẻ những ứng dụng thú vị với Jev. Mô hình này được cho là có rất nhiều ứng dụng và có thể thay thế mô hình ngôn ngữ lớn (LLM) trong các tác vụ phân loại và ra quyết định. Trong bài viết này, chúng ta sẽ cùng tìm hiểu xem mô hình Jev là gì, tại sao sự ra đời của Jev được ví như “khoảnh khắc ChatGPT” của bài toán phân loại, cách sử dụng Jev qua giao diện lập trình ứng dụng (API), những ứng dụng tiêu biểu cũng như các giới hạn cần lưu ý của mô hình này.
1. Mô hình Jev là gì và vì sao được chú ý
1.1. Vì sao LLM chưa tối ưu cho những quyết định đơn giản?
Mô hình ngôn ngữ lớn về bản chất là mô hình sinh văn bản dựa trên ngữ cảnh đầu vào. Cho trước một ngữ cảnh đầu vào (context), mô hình lần lượt sinh ra các từ (token) tiếp theo dựa trên phân phối xác suất của token kế tiếp.
Tính chất này của LLM khiến nó có một số nhược điểm. Thứ nhất là hiện tượng ảo giác (hallucination): mô hình có thể sinh ra nội dung không có thật, đặc biệt khi gặp những ngữ cảnh ít xuất hiện trong dữ liệu huấn luyện. Thứ hai, trong những ngữ cảnh chỉ cần đưa ra quyết định dạng phân loại, việc sử dụng LLM khá “cồng kềnh” và không đúng bản chất của những bài toán dạng này: đầu ra là chuỗi văn bản tự do, phải được phân tích (parse) lại trước khi phần mềm có thể sử dụng.
1.2. Jev – Mô hình AI đưa quyết định nhanh
Jev là mô hình do TypeSafe AI, một công ty khởi nghiệp có trụ sở tại San Francisco (Mỹ), phát triển. TypeSafe được thành lập năm 2024 bởi Diogo Almeida – người từng tham gia xây dựng các phương pháp huấn luyện mô hình tuân theo chỉ dẫn (instruction following) tại OpenAI. Theo bài giới thiệu trên blog của TypeSafe AI, Jev là mô hình đầu tiên thuộc lớp “System One” – lớp mô hình AI được xây dựng để đưa ra những quyết định nhanh, có cấu trúc (structured decision) mà phần mềm có thể sử dụng trực tiếp.
Thuật ngữ System One bắt nguồn từ khái niệm được phổ biến rộng rãi qua cuốn sách Thinking, Fast and Slow (Tư duy nhanh và chậm) của Daniel Kahneman – nhà tâm lý học người Mỹ gốc Israel, đạt giải Nobel Kinh tế năm 2002. Theo Kahneman, System One là hệ thống tư duy nhanh, tự động, trực giác và ít tốn công sức, trong khi System Two là hệ thống tư duy chậm, có chủ đích, phân tích và cần sự tập trung.
Mô hình Jev được tạo ra nhằm giải quyết những hạn chế của LLM trong những tác vụ phân loại. Khác với LLM, Jev không sinh văn bản mà được tối ưu cho các bài toán ra quyết định. Có thể tưởng tượng Jev giống như một lời gọi hàm: đầu vào là dữ liệu dạng phi cấu trúc, đầu ra là kết quả phân loại có cấu trúc với kiểu dữ liệu được định nghĩa trước, kèm theo xác suất cho từng phương án. Hình 1 so sánh cách LLM và Jev giải quyết cùng một bài toán phân loại.
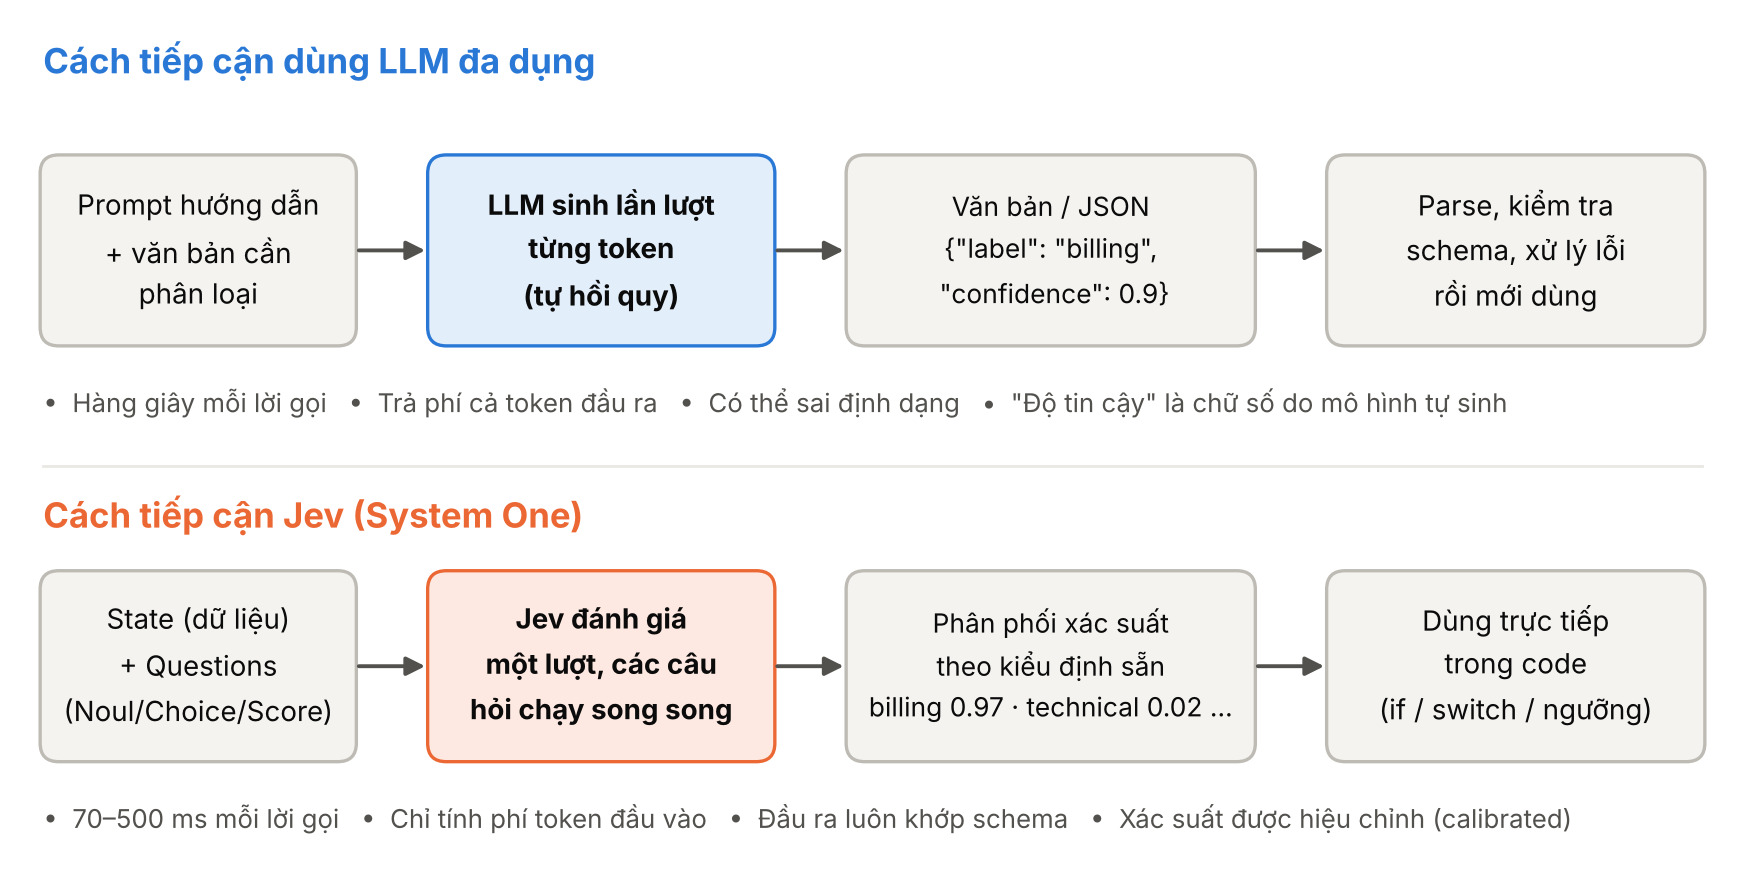
Hình 1. So sánh cách tiếp cận dùng LLM đa dụng và dùng Jev cho bài toán phân loại
Theo TypeSafe, Jev đặc biệt hữu ích khi được nhúng vào các bước cần ra quyết định trong workflow. Ví dụ, trong các ứng dụng Agentic AI, Jev có thể được dùng ở bước lựa chọn mô hình thực thi tác vụ (model routing) hay bước kiểm tra đầu vào, đầu ra (guardrail), với chi phí thấp hơn và tốc độ nhanh hơn nhiều so với sử dụng LLM.
1.3. Trước Jev, doanh nghiệp giải bài toán phân loại thế nào?
Bài toán phân loại (classification) là một bài toán kinh điển trong ngành trí tuệ nhân tạo. Ví dụ, mô hình AI có thể giúp phân loại email trong hộp thư thành thư rác hoặc không phải thư rác hay phân loại các bình luận dưới một bài viết trên mạng xã hội thành khiếm nhã hoặc không khiếm nhã. Có thể nói rất nhiều vấn đề mà AI giải quyết có thể mô hình hóa thành bài toán phân loại. Ngay cả việc mô hình ngôn ngữ sinh từ (token) kế tiếp dựa trên ngữ cảnh đầu vào, về bản chất, cũng là một bài toán phân loại: phân loại ngữ cảnh đầu vào vào một trong các token của bộ từ vựng (vocabulary), trong đó mỗi token là một loại.
Chúng ta thường giải quyết bài toán phân loại theo một trong hai cách:
- Huấn luyện mô hình phân loại chuyên biệt: huấn luyện từ đầu các mô hình như Naïve Bayes, SVM, RNN, v.v. hoặc tinh chỉnh (fine-tune) các mô hình ngôn ngữ đã được huấn luyện trước như BERT trên dữ liệu huấn luyện gồm các mẫu và nhãn. Cách làm này cho độ chính xác cao trên từng bài toán cụ thể nhưng tốn công chuẩn bị dữ liệu và huấn luyện mô hình. Một mô hình được huấn luyện cho bài toán này thường không thể dùng cho bài toán khác, buộc chúng ta phải lặp lại quy trình: chuẩn bị dữ liệu – huấn luyện mô hình.
- Viết hướng dẫn (prompt) cho các mô hình AI tạo sinh đa dụng như GPT, Claude, DeepSeek. Với cách làm này, chúng ta không cần phải tạo dữ liệu huấn luyện và huấn luyện mô hình mà chỉ cần viết hướng dẫn sao cho rõ ràng, đầy đủ. Tuy nhiên, cách làm này có một số nhược điểm. Thứ nhất, các LLM đa dụng có kích thước lớn, tốc độ xử lý thường chậm và chi phí cao. Thứ hai, như chúng tôi đã đề cập ở trên, LLM có thể bị ảo giác và có thể sinh ra đầu ra sai định dạng khi được yêu cầu trả về dữ liệu có cấu trúc (ví dụ đầu ra dạng JSON). Thứ ba, các con số mà LLM trả về như xác suất hay độ tin cậy (confidence) thực chất cũng chỉ là văn bản do mô hình sinh ra, thường không phản ánh đúng khả năng câu trả lời là đúng. Cuối cùng, việc dùng mô hình suy luận sâu (mô hình kiểu System Two) cho những bài toán phân loại đơn giản chẳng khác nào “dùng dao mổ trâu để giết gà”.
1.4. Vì sao Jev được ví là “khoảnh khắc ChatGPT” của bài toán phân loại?
Ngay sau khi TypeSafe công bố Jev, mô hình này đã nhận được sự quan tâm lớn của cộng đồng nghiên cứu và ứng dụng trí tuệ nhân tạo. Rất nhiều ứng dụng, use case đã nhanh chóng được các nhà phát triển xây dựng và chia sẻ. Chẳng hạn, trang Made with Jev đã tập hợp hơn 850 dự án, ứng dụng được xây dựng với Jev chỉ sau khoảng một tháng. Nhà nghiên cứu Sebastian Raschka trong bài viết của mình đã ví sự ra đời của TypeSafe Jev như “khoảnh khắc ChatGPT” của bài toán phân loại: lần đầu tiên có thể phân loại đủ loại văn bản với chi phí thấp mà không phải tinh chỉnh một mô hình riêng cho từng tác vụ.
Bài toán phân loại không mới trong AI nên bạn đọc có thể thắc mắc, vì sao mô hình này lại “viral” như vậy? Theo tài liệu của TypeSafe và đánh giá của các chuyên gia, có một số lý do chính:
- Jev là mô hình có khả năng thực hiện bài toán phân loại với nhiều loại dữ liệu khác nhau mà không cần tinh chỉnh mô hình. Điều này tương tự như LLM có thể giải quyết nhiều loại bài toán khác nhau như dịch thuật, sinh code hay phân loại chỉ bằng cách đưa vào hướng dẫn và cung cấp thông tin ngữ cảnh.
- Độ chính xác của Jev cho các tác vụ phân loại ngang với các LLM tiên tiến (frontier).
- Đầu ra của Jev luôn tuân thủ đúng kiểu dữ liệu (schema) được định nghĩa trước. TypeSafe khẳng định Jev không thể tạo ra câu trả lời nằm ngoài các phương án đã khai báo, khác với LLM đôi khi sinh JSON sai định dạng hoặc nhãn không tồn tại.
- Các con số như xác suất lựa chọn, mức độ tin cậy của đầu ra (confidence score) của Jev được huấn luyện để hiệu chỉnh (calibrated): theo TypeSafe, độ tin cậy càng cao thì khả năng câu trả lời đúng càng cao, nhờ đó có thể dùng làm ngưỡng để quyết định khi nào tự động xử lý, khi nào chuyển cho con người.
- Tốc độ thực thi các bài toán phân loại của Jev nhanh hơn LLM tới hàng trăm lần. Theo TypeSafe, mỗi lời gọi Jev mất khoảng 70 ~ 500 mili giây, nhanh hơn 40 ~ 200 lần so với các LLM hàng đầu (vốn mất từ 3 đến 329 giây cho một lời gọi đầu-cuối); trên bộ đánh giá các workflow của hãng, Jev nhanh hơn 193,6 lần và rẻ hơn 444,6 lần.
- Giá API của TypeSafe Jev rất rẻ và chỉ tính phí trên token đầu vào (input), token đầu ra miễn phí: chỉ 0,042 USD cho mỗi 1 triệu token đầu vào. Trong khi đó, giá token đầu vào của các LLM phổ biến dao động từ 0,2 đến 10 USD/1 triệu token, còn token đầu ra thường đắt gấp khoảng 5 lần token đầu vào.
Với những đặc điểm trên, TypeSafe Jev được các nhà phát triển sử dụng để thay thế LLM trong các tác vụ phân loại, ra quyết định nhẹ trong pipeline xử lý – những nơi chỉ cần mô hình kiểu System One.
1.5. Bên trong Jev và cuộc đua của OpenAI, Cloudflare, AWS
Mô hình TypeSafe Jev là mô hình đóng (mô hình không công bố trọng số, không biết kiến trúc bên trong) nên chúng ta không biết cụ thể kiến trúc của mô hình này, cách huấn luyện mô hình ra sao ngoài những gì được TypeSafe giới thiệu trên trang chủ. Theo công bố của TypeSafe, công ty sử dụng phương pháp huấn luyện gọi là Reinforcement Learning for Calibrated Decisions (RLCD) để huấn luyện Jev.
Theo phỏng đoán của một số chuyên gia, trong đó có Sebastian Raschka, Jev là mô hình có kích thước nhỏ, có thể tương tự các mô hình mã hóa (encoder) như ModernBERT – điều lý giải cho độ trễ thấp – và những gì tạo nên sức mạnh của mô hình này nằm chủ yếu ở dữ liệu huấn luyện và phương pháp huấn luyện nói trên. Các nhà nghiên cứu, kỹ sư đang tích cực khám phá kiến trúc đằng sau Jev và chúng ta có thể kỳ vọng sẽ sớm có “khoảnh khắc DeepSeek của Jev”.
Trên thực tế, cuộc đua đã bắt đầu. Chỉ khoảng hai tuần sau khi Jev ra mắt, Cloudflare công bố họ mô hình Clef với trọng số mở (giấy phép Apache 2.0), xây dựng trên nền Qwen và tự công bố vượt Jev trên ba trong bốn bộ đánh giá của TypeSafe; Amazon (AWS) phát hành mô hình Strands Decider 2B đủ nhỏ để chạy cục bộ. Ngày 6/10/2026, OpenAI mở Decisions API – dịch vụ có cùng ba dạng câu hỏi (xác suất một mệnh đề đúng, lựa chọn, chấm điểm), hỗ trợ cả đầu vào hình ảnh, với giá 0,10 USD cho mỗi triệu token đầu vào.
2. Dùng thử Jev: hướng dẫn nhanh cho lập trình viên
Vì Jev là mô hình đóng, nên hiện nay chúng ta chỉ có thể sử dụng Jev thông qua API mà TypeSafe cung cấp. Bên cạnh API gốc[1] và các bộ SDK chính thức cho Python và JavaScript/TypeScript, Jev còn được tích hợp vào nhiều nền tảng như Vercel AI SDK, Cloudflare Workers AI hay thư viện LangChain.
2.1. Ba kiểu câu hỏi: Có/Không, Chọn một trong các lựa chọn, Chấm điểm
Mỗi lời gọi Jev API gồm hai thành phần chính: trạng thái (state) – dữ liệu cần đánh giá, có thể là văn bản, đối tượng JSON hay lịch sử hội thoại – và một tập câu hỏi (questions). Các câu hỏi trong cùng một lời gọi được đánh giá song song trên cùng một state, nên việc thêm câu hỏi hầu như không làm tăng thời gian phản hồi. TypeSafe định nghĩa 3 loại câu hỏi cơ bản (primitive) để giải quyết 3 dạng bài toán ra quyết định khác nhau:
- Noul: câu hỏi dạng có/không (phân loại nhị phân), chẳng hạn email có phải là thư rác không. Kết quả trả về là một số trong khoảng 0 – 1, thể hiện xác suất câu trả lời là “có”.
- Choice: chọn một phương án trong danh sách do người dùng định nghĩa (tối đa 255 phương án), ví dụ phân loại yêu cầu hỗ trợ vào một trong các nhóm billing, technical, sales hoặc other. Kết quả gồm phương án được chọn, xác suất của từng phương án (tổng bằng 1) và độ tin cậy (confidence) được tính từ mức độ phân tán của phân phối xác suất.
- Score: chấm điểm theo một thang có thứ bậc do người dùng mô tả. Ví dụ, với thang đo mức độ bực bội 0 = bình tĩnh, 1 = lo lắng, 2 = tức giận, điểm 1,8 là vị trí trung bình có trọng số xác suất (tổng của từng mức nhân với xác suất của mức đó), nằm giữa “lo lắng” và “tức giận”. Lưu ý đây không phải là phần trăm độ tin cậy.
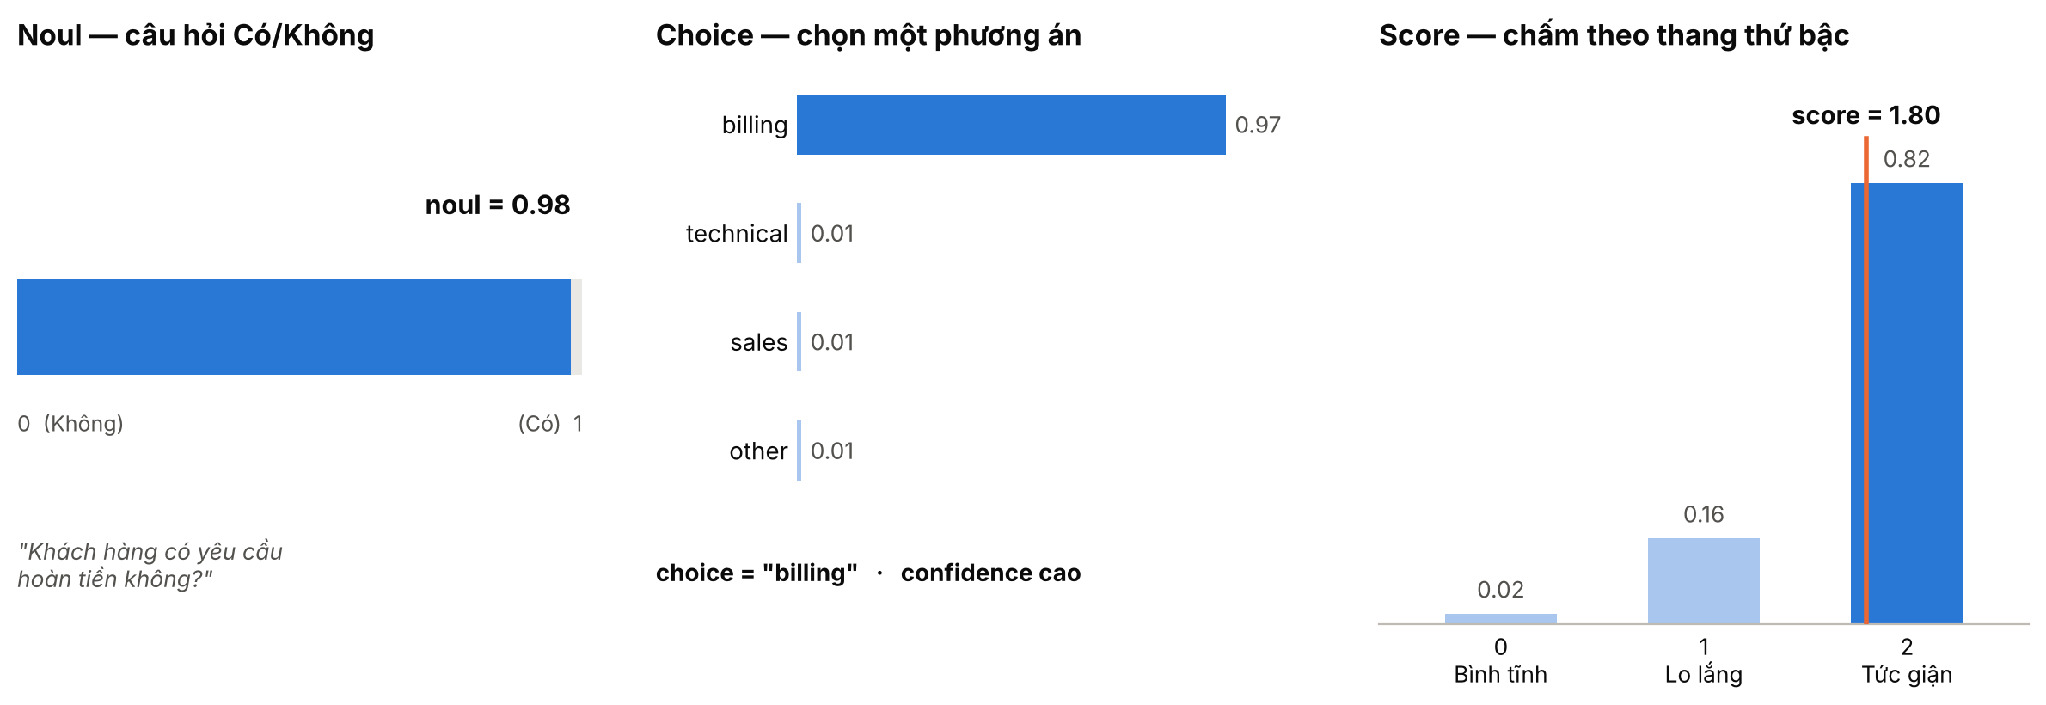
Hình 2. Ba loại câu hỏi của Jev API và dạng kết quả trả về (số liệu minh họa)
Ngoài ba loại trên, phiên bản Jev 1.14 (phát hành ngày 14/10/2026) bổ sung kiểu câu hỏi Box để xác định vị trí đối tượng trong ảnh; khả năng nhận đầu vào hình ảnh hiện vẫn ở chế độ thử nghiệm. Mỗi lời gọi mặc định nhận tối đa 64 nghìn token (32 nghìn token cho mỗi câu hỏi).
2.2. Ví dụ: tự động phân loại yêu cầu hỗ trợ khách hàng
Ví dụ dưới đây minh họa lời gọi Jev API bằng Python SDK cho bài toán phân loại yêu cầu hỗ trợ khách hàng. Chỉ với một lời gọi, chúng ta đặt đồng thời ba câu hỏi thuộc ba loại khác nhau cho cùng một tin nhắn của khách hàng.
Bước 1 – cài đặt SDK và khai báo API key:
pip install typesafe-sdk
export TYPESAFE_API_KEY="<API key của bạn>"
Bước 2 – gọi API với một state và ba câu hỏi:
from typesafe_sdk import TypeSafeClient, Noul, Choice, Score

ticket = (
    "Tôi bị trừ tiền hai lần cho cùng một đơn hàng. "
    "Rất bực mình! Hãy hoàn lại khoản bị trừ thừa."
)

# TypeSafeClient tự đọc API key từ biến môi trường TYPESAFE_API_KEY
with TypeSafeClient() as client:
    response = client.system_one(
        model="jev-latest",
        state=ticket,
        questions={
            "wants_refund": Noul(
                instructions="Khách hàng có yêu cầu hoàn tiền không?",
            ),
            "department": Choice(
                instructions="Bộ phận nào nên xử lý yêu cầu này?",
                criteria={
                    "billing": "Thanh toán, hóa đơn, trừ tiền",
                    "technical": "Lỗi kỹ thuật, sự cố hệ thống",
                    "sales": "Tư vấn mua hàng, báo giá",
                    "other": "Các yêu cầu khác",
                },
            ),
            "frustration": Score(
                instructions="Khách hàng bực bội ở mức độ nào?",
                criteria=["Bình tĩnh", "Lo lắng", "Tức giận"],
            ),
        },
    )

print(response.model_dump_json())
Kết quả trả về có dạng JSON như sau (giá trị minh họa, đã rút gọn):
{
  "model": "jev-1.14.0",
  "usage": {
    "input_tokens": 475,
    "output_tokens": 80
  },
  "answers": {
    "wants_refund": {
      "type": "noul",
      "noul": 0.98
    },
    "department": {
      "type": "choice",
      "choice": "billing",
      "confidence": 1,
      "probabilities": {
        "billing": 1,
        "technical": 0,
        "sales": 0,
        "other": 0
      }
    },
    "frustration": {
      "type": "score",
      "score": 1.96,
      "confidence": 0.95,
      "legend": {
        "0": "Bình tĩnh",
        "1": "Lo lắng",
        "2": "Tức giận"
      },
      "probabilities": {
        "0": 0.01,
        "1": 0.01,
        "2": 0.98
      }
    }
  }
}
Có thể thấy, mọi câu trả lời đều đúng kiểu dữ liệu đã khai báo và đi kèm phân phối xác suất, nên lập trình viên có thể dùng trực tiếp trong các câu lệnh điều kiện. Chẳng hạn, hệ thống chỉ tự động chuyển yêu cầu tới bộ phận thanh toán khi độ tin cậy lớn hơn 0,8, còn lại chuyển cho nhân viên xem xét – mẫu thiết kế được TypeSafe gọi là định tuyến theo ngưỡng tin cậy (confidence-gated routing).
Ngoài SDK, có thể gọi trực tiếp Jev qua HTTP:
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "Tôi bị trừ tiền hai lần cho cùng một đơn hàng...",
    "questions": {
      "wants_refund": {
        "type": "noul",
        "instructions": "Khách hàng có yêu cầu hoàn tiền không?"
      }
    }
  }'
3. Jev mang lại gì cho doanh nghiệp?
Theo bản đồ use case của TypeSafe, Jev phù hợp với bất kỳ bước nào trong hệ thống phần mềm mà ở đó tập đáp án có thể liệt kê trước: phân loại, phát hiện, chấm điểm, định tuyến, tìm kiếm, xếp hạng, kiểm chứng hay trích xuất trường dữ liệu. Có thể chia các ứng dụng của Jev thành các nhóm chính dưới đây.
3.1. Tự động hóa quy trình: CSKH, bảo hiểm, ngân hàng, pháp lý
Đây là nhóm ứng dụng trực tiếp nhất: thay thế các lời gọi LLM dùng để phân loại trong những quy trình chạy nền, lặp lại với khối lượng lớn. Bản đồ use case của TypeSafe liệt kê nhiều kịch bản theo ngành:
- Chăm sóc khách hàng: phân loại ticket, trích xuất vấn đề từ cuộc gọi, phát hiện mức độ khẩn cấp, nguy cơ rời bỏ (churn) hay yêu cầu hoàn tiền và định tuyến tới đúng bộ phận.
- Bảo hiểm: phân loại hồ sơ bồi thường, gắn cờ các dấu hiệu phức tạp hoặc nghi ngờ gian lận để ưu tiên và chuyển cấp xử lý.
- Tài chính – ngân hàng: đánh giá hồ sơ KYC, đối sánh thực thể, ưu tiên các cảnh báo và chuyển vụ việc nghi vấn cho bộ phận điều tra phòng chống tội phạm tài chính.
- Pháp lý và tuân thủ: phân loại văn bản, phát hiện điều khoản bị thiếu hoặc nội dung bị cấm.
- Tuyển dụng, bán hàng, kiểm duyệt nội dung: chấm điểm ứng viên theo tiêu chí, đánh giá mức độ phù hợp của khách hàng tiềm năng, phát hiện nội dung độc hại, spam và quyết định cho phép, cảnh báo hay chặn theo mức độ nghiêm trọng.
Chi phí thấp khiến những tác vụ trước đây “không đáng” gọi LLM nay trở nên khả thi, chẳng hạn một dự án cộng đồng phân loại 500 email với chi phí khoảng 3,5 cent. Điểm đáng chú ý là Jev không loại bỏ vai trò của LLM hay code truyền thống mà phân công lại công việc: Jev đảm nhận các phán đoán nhanh, code đảm nhận luật nghiệp vụ, còn LLM tập trung vào sinh nội dung (Hình 3). Trong ví dụ yêu cầu hoàn tiền ở trên, Jev xác định bộ phận xử lý và mức độ bực bội của khách hàng, code kiểm tra điều kiện hoàn tiền, còn LLM soạn thư trả lời khách hàng.
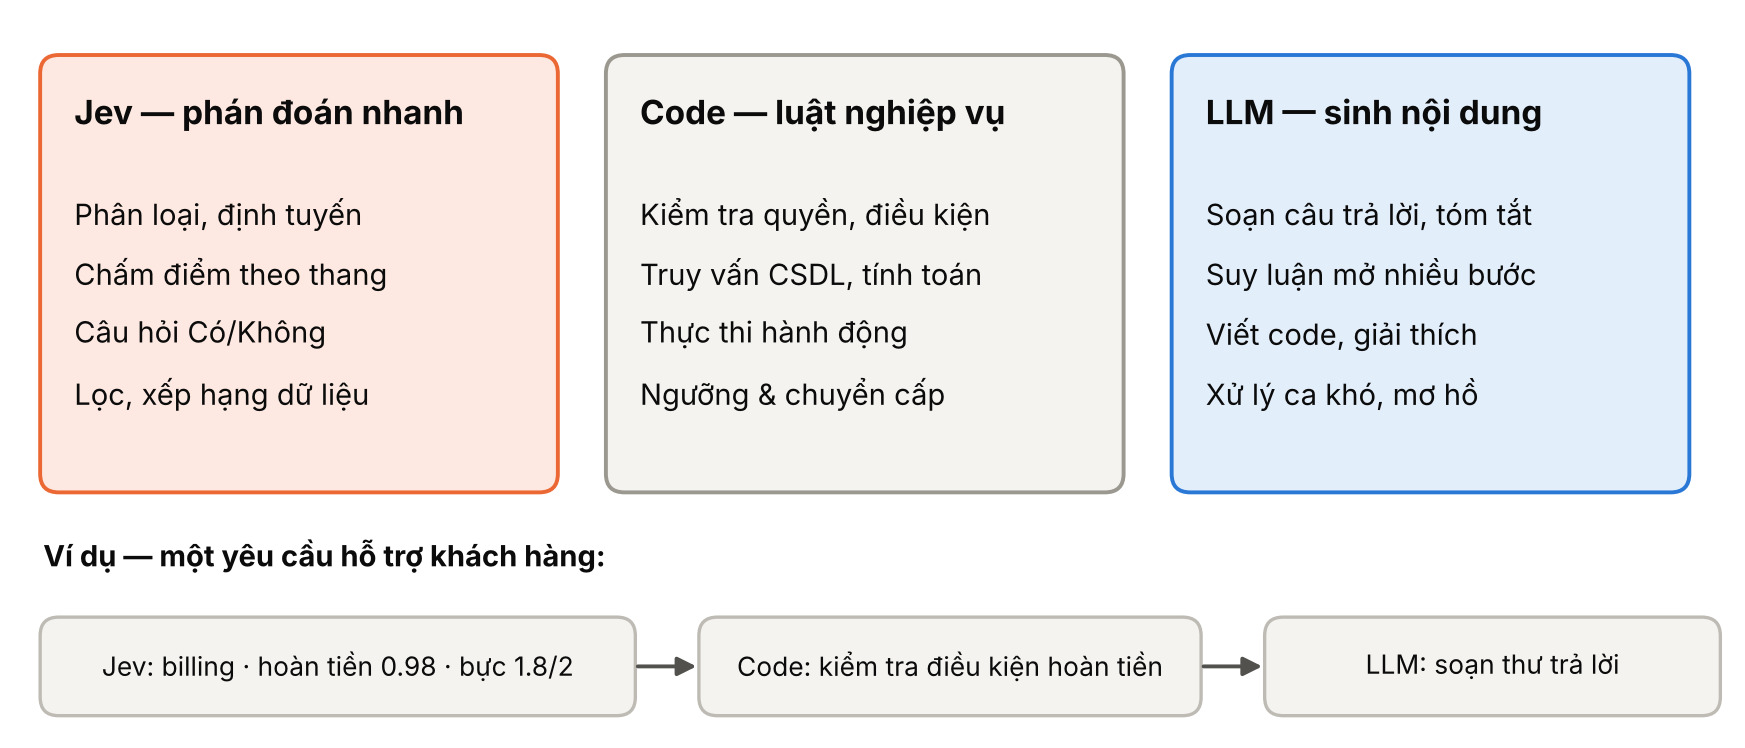
Hình 3. Phân công công việc giữa Jev, code và LLM trong một quy trình xử lý
3.2. Giúp AI agent nhanh hơn, rẻ hơn và dễ kiểm soát hơn
Trong các hệ thống AI agent, vòng lặp tác nhân có rất nhiều điểm cần ra quyết định nhanh: dùng mô hình nào, có cho phép thực thi lệnh này không, kết quả công cụ nào cần giữ lại trong ngữ cảnh… Nếu mỗi quyết định đều gọi LLM, độ trễ và chi phí sẽ tăng nhanh theo số bước. Jev được thiết kế để đảm nhận các điểm quyết định này (Hình 4):
- Định tuyến mô hình (model routing): Jev có thể được sử dụng để chọn mô hình phù hợp cho mỗi lượt chạy dựa trên tiêu chí do người dùng định nghĩa; xác suất và độ tin cậy được lưu lại trong trạng thái của agent.
- Guardrail cho lời gọi công cụ: lập trình viên có thể sử dụng Jev để kiểm tra từng lời gọi công cụ (ví dụ lệnh bash) và chặn các lệnh rủi ro trước khi thực thi. Nhờ chi phí và độ trễ thấp, việc kiểm tra từng hành động của agent trở nên khả thi.
- Lọc và nén ngữ cảnh: dự án mã nguồn mở tạo plugin Fast Jev Compaction cho Claude Code dùng Jev chấm điểm kết quả công cụ để quyết định giữ nguyên, cắt bớt hay loại bỏ, thay vì tóm tắt bằng LLM.
- Kiểm chứng đầu ra (universal verification): kiểm tra prompt, chuỗi suy luận, lời gọi công cụ và đầu ra của LLM nhằm phát hiện jailbreak, prompt injection, trích dẫn sai hay ảo giác.
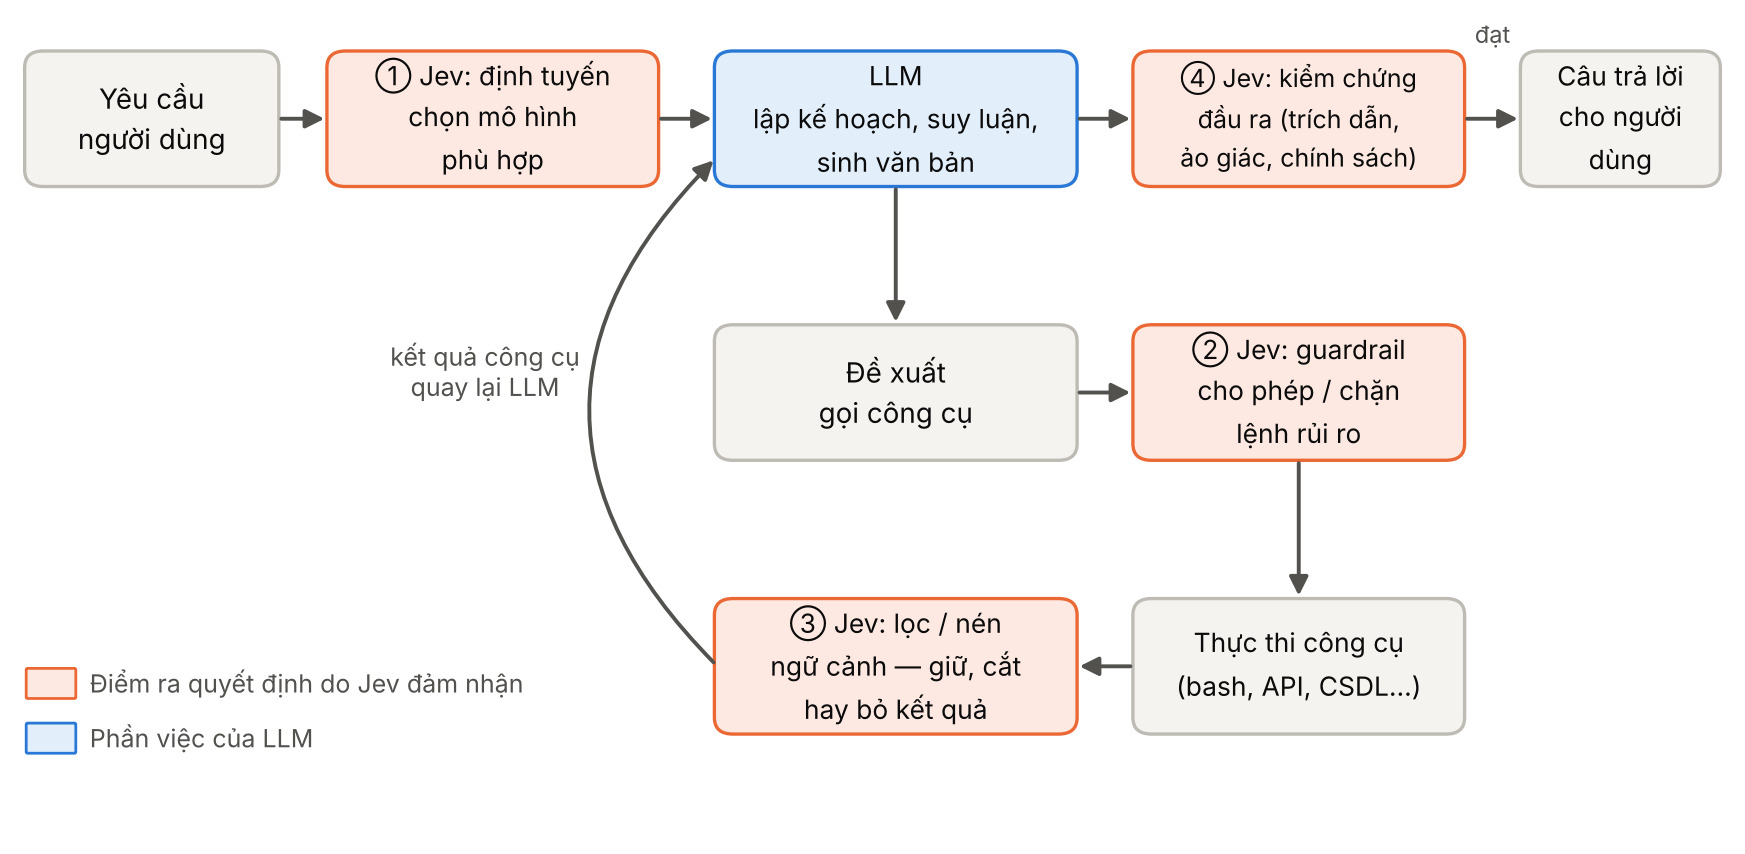
Hình 4. Các điểm ra quyết định mà Jev có thể đảm nhận trong vòng lặp của một AI agent
3.3. Xử lý kho dữ liệu lớn với chi phí thấp
Với mức giá 0,042 USD cho mỗi triệu token, việc chạy mô hình AI trên toàn bộ một kho dữ liệu lớn trở nên khả thi về chi phí. Jev có thể được dùng để tìm kiếm ngữ nghĩa, xếp hạng lại (rerank) các đoạn văn bản trong hệ thống RAG, gắn nhãn hàng loạt cho tài liệu hay trích xuất đặc trưng ngữ nghĩa làm đầu vào cho các mô hình học máy truyền thống. Chẳng hạn, dự án pg-jev cho phép viết điều kiện lọc bằng ngôn ngữ tự nhiên ngay trong truy vấn PostgreSQL, phần còn lại vẫn do SQL đảm nhận. Trong thử nghiệm của Sebastian Raschka, Jev phân loại toàn bộ 25.000 đánh giá phim của tập IMDb trong khoảng 22 phút với chi phí chưa đến 0,65 USD.
3.4. Những ứng dụng cần phản hồi tức thì
Độ trễ tính bằng mili giây mở ra những ứng dụng cần phản hồi tức thì mà LLM khó đáp ứng. TypeSafe minh họa bằng việc dùng Jev chơi game Doom với tốc độ 10 truy vấn mỗi giây, chi phí khoảng 7 USD mỗi giờ. Cộng đồng cũng đã xây dựng nhiều demo như agent chơi Super Mario Bros, agent hoàn thành trò chơi Minecraft, điều khiển drone trong môi trường mô phỏng MuJoCo hay agent duyệt web Jev Ultrafast, trong đó Jev chọn từng hành động còn một LLM nhỏ đảm nhận phần nhập văn bản.
3.5. Cơ hội cho doanh nghiệp và khu vực công Việt Nam
Từ góc nhìn của chúng tôi, mô hình kiểu System One như Jev có nhiều tiềm năng trong các bài toán chuyển đổi số tại Việt Nam: phân loại và định tuyến phản ánh, kiến nghị của người dân tới đúng cơ quan xử lý; phân loại hồ sơ thủ tục hành chính; sàng lọc hồ sơ bồi thường bảo hiểm; hay làm lớp guardrail kiểm tra đầu vào, đầu ra cho các trợ lý ảo dịch vụ công. Tuy nhiên, các ứng dụng này đòi hỏi đánh giá kỹ hiệu năng trên dữ liệu tiếng Việt, đồng thời cân nhắc yêu cầu về bảo mật và lưu trữ dữ liệu khi sử dụng một dịch vụ API đặt ở nước ngoài.
4. Có nên dùng Jev? Những lưu ý trước khi triển khai
Jev đại diện cho một hướng tiếp cận mới: thay vì dùng một mô hình sinh đa dụng cho mọi việc, các bước ra quyết định trong phần mềm được giao cho một lớp mô hình chuyên biệt, nhanh, rẻ, có đầu ra đúng cấu trúc mong muốn và đi kèm xác suất. Nếu LLM đóng vai trò “System Two” – tư duy chậm, suy luận sâu – thì Jev là “System One” – phản xạ nhanh; hai lớp mô hình này bổ trợ cho nhau thay vì thay thế nhau.
Tuy vậy, khi cân nhắc sử dụng Jev, bạn đọc cần lưu ý một số điểm:
- Mô hình đóng: kiến trúc, dữ liệu và thuật toán huấn luyện chưa được công bố; người dùng phụ thuộc vào một nhà cung cấp và phải gửi dữ liệu ra bên ngoài – yếu tố cần cân nhắc với dữ liệu nhạy cảm.
- Không sinh văn bản: Jev không thể viết câu trả lời, tóm tắt hay giải thích lý do; các câu hỏi phụ thuộc lẫn nhau (cần kết quả của câu này mới đặt được câu kia) phải tách thành nhiều lời gọi.
- Xác suất không phải là bảo đảm: tính hiệu chỉnh (calibration) được đo trên tập hợp nhiều dự đoán, không bảo đảm từng câu trả lời đơn lẻ là đúng; “không ảo giác” chỉ có nghĩa là đầu ra luôn khớp schema chứ không có nghĩa là nội dung luôn đúng.
- Hiệu năng với tiếng Việt chưa được kiểm chứng công khai: đây là điểm cần đánh giá kỹ trên dữ liệu thực tế trước khi đưa vào sản phẩm.
Lời khuyên thực tế cho các đội phát triển là bắt đầu từ một lời gọi phân loại hoặc định tuyến sẵn có mà tập đáp án có thể liệt kê trước, so sánh Jev với giải pháp hiện tại trên cùng một tập dữ liệu có nhãn (bao gồm cả các trường hợp mơ hồ), và đo đầy đủ độ chính xác, độ trễ đầu-cuối cũng như tổng chi phí, kể cả chi phí gọi lại và phương án dự phòng.
Cuối cùng, dù Jev có trở thành chuẩn mực mới hay không, sự xuất hiện liên tiếp của các sản phẩm tương tự từ OpenAI, Cloudflare hay Amazon cho thấy xu hướng tách lớp “ra quyết định” khỏi lớp “sinh nội dung” đang được các hãng lớn coi trọng, và nhiều khả năng sẽ ảnh hưởng tới cách chúng ta xây dựng các hệ thống AI trong thời gian tới.
Tài liệu tham khảo
- Diogo Almeida. Introducing System One Models & Jev. TypeSafe AI Blog, 15/9/2026. https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe Docs. Use case map. https://docs.typesafe.ai/concepts/use-case-map
- Sebastian Raschka. Language Models for Text Classification: From Bag-of-Words to Jev. Ahead of AI, 29/9/2026. https://magazine.sebastianraschka.com/p/classifier-history-and-jev
- Building a Harness with Jev. LangChain Blog, 17/9/2026. https://www.langchain.com/blog/building-a-harness-with-jev
- Bilgin Ibryam. Jev and LLMs: who does what? The Generative Programmer, 20/9/2026. https://generativeprogrammer.com/p/jev-and-llms-who-does-what
- TypeSafe Docs. Quickstart; Primitives: Noul, Choice, Score. https://docs.typesafe.ai/introduction/quickstart
- TypeSafe Docs. Models. https://docs.typesafe.ai/models
- Made with Jev – tổng hợp các dự án xây dựng với Jev. https://madewithjev.com/
- ChatGPT co-creator launches TypeSafe AI with Jev. VKTR, 16/9/2026. https://www.vktr.com/ai-platforms/chatgpt-cocreator-launches-typesafe-ai-with-jev/
- Let’s Data Science. OpenAI Jev rival in three weeks – TypeSafe raised 870 million (10/2026). https://letsdatascience.com/blog/openai-jev-rival-three-weeks-typesafe-raised-870-million
| Bài viết độc quyền bởi Chuyên gia công nghệ FPT IS, Tập đoàn FPT
Phạm Quang Nhật Minh Giám đốc Trung tâm nghiên cứu và phát triển trí tuệ nhân tạo (FPT IS AI R&D Center) Tiến sỹ ngành khoa học thông tin, chuyên gia trong lĩnh vực xử lý ngôn ngữ tự nhiên (NLP), với 18 năm kinh nghiệm nghiên cứu và phát triển trong môi trường hàn lâm và công nghiệp, là tác giả và đồng tác giả của nhiều bài báo khoa học trong lĩnh vực xử lý ngôn ngữ tự nhiên. Chủ đề nghiên cứu của ông hiện tại là về các mô hình ngôn ngữ lớn và ứng dụng. |